




L’IA dans les processus de l’entreprise
Le second cerveau de votre entreprise
Un seul endroit pour demander « où est-ce », « combien ça coûte », « comment on fait » et obtenir la réponse tirée de vos documents, avec le lien vers la source. Nous y arrivons en trois étapes : former les personnes, automatiser le travail répétitif, tout relier dans un hub qui sait aussi agir.
Où en sont les entreprises italiennes
LE POINT DE DÉPART
- 16,4 %
des entreprises italiennes de 10 salariés ou plus utilisent l’IA. La moyenne européenne est de 20 %.
ISTAT et Eurostat, 2025
- 7 %
des PME italiennes ont un programme structuré de formation à l’IA.
Osservatori Politecnico di Milano, 2026
- 60 %
des entreprises qui ont envisagé l’IA sans l’adopter citent le manque de compétences comme obstacle. 45 % citent la qualité des données.
ISTAT, 2025
Ceux qui n’ont pas encore commencé ne sont pas les seuls en retard. Les obstacles sont toujours les deux mêmes : les compétences et des données en ordre. C’est par là que nous commençons.
En termes simples
COMMENT ÇA MARCHE
Pour les connexions, nous utilisons MCP, le standard ouvert désormais pris en charge par ChatGPT, Claude, Gemini et Copilot. Si demain vous changez de modèle, les connexions restent.
- 1. Nous connectons les sources. Drive, e-mails, CRM, ERP, tickets et manuels restent où ils sont : le hub les lit et se met à jour tout seul.
- 2. Nous les rendons consultables par le sens. Les documents sont découpés en morceaux et indexés selon leur sens. Vous trouvez la procédure même sans vous rappeler son nom.
- 3. Nous répondons avec les sources. L’IA ne répond qu’à partir de ce qu’elle a trouvé et cite le document. Si l’information n’existe pas, elle le dit.
- 4. Nous respectons les droits d’accès. Chacun voit ce qu’il voyait déjà. Le technicien ne lit pas les marges, le commercial ne lit pas les fiches de paie.
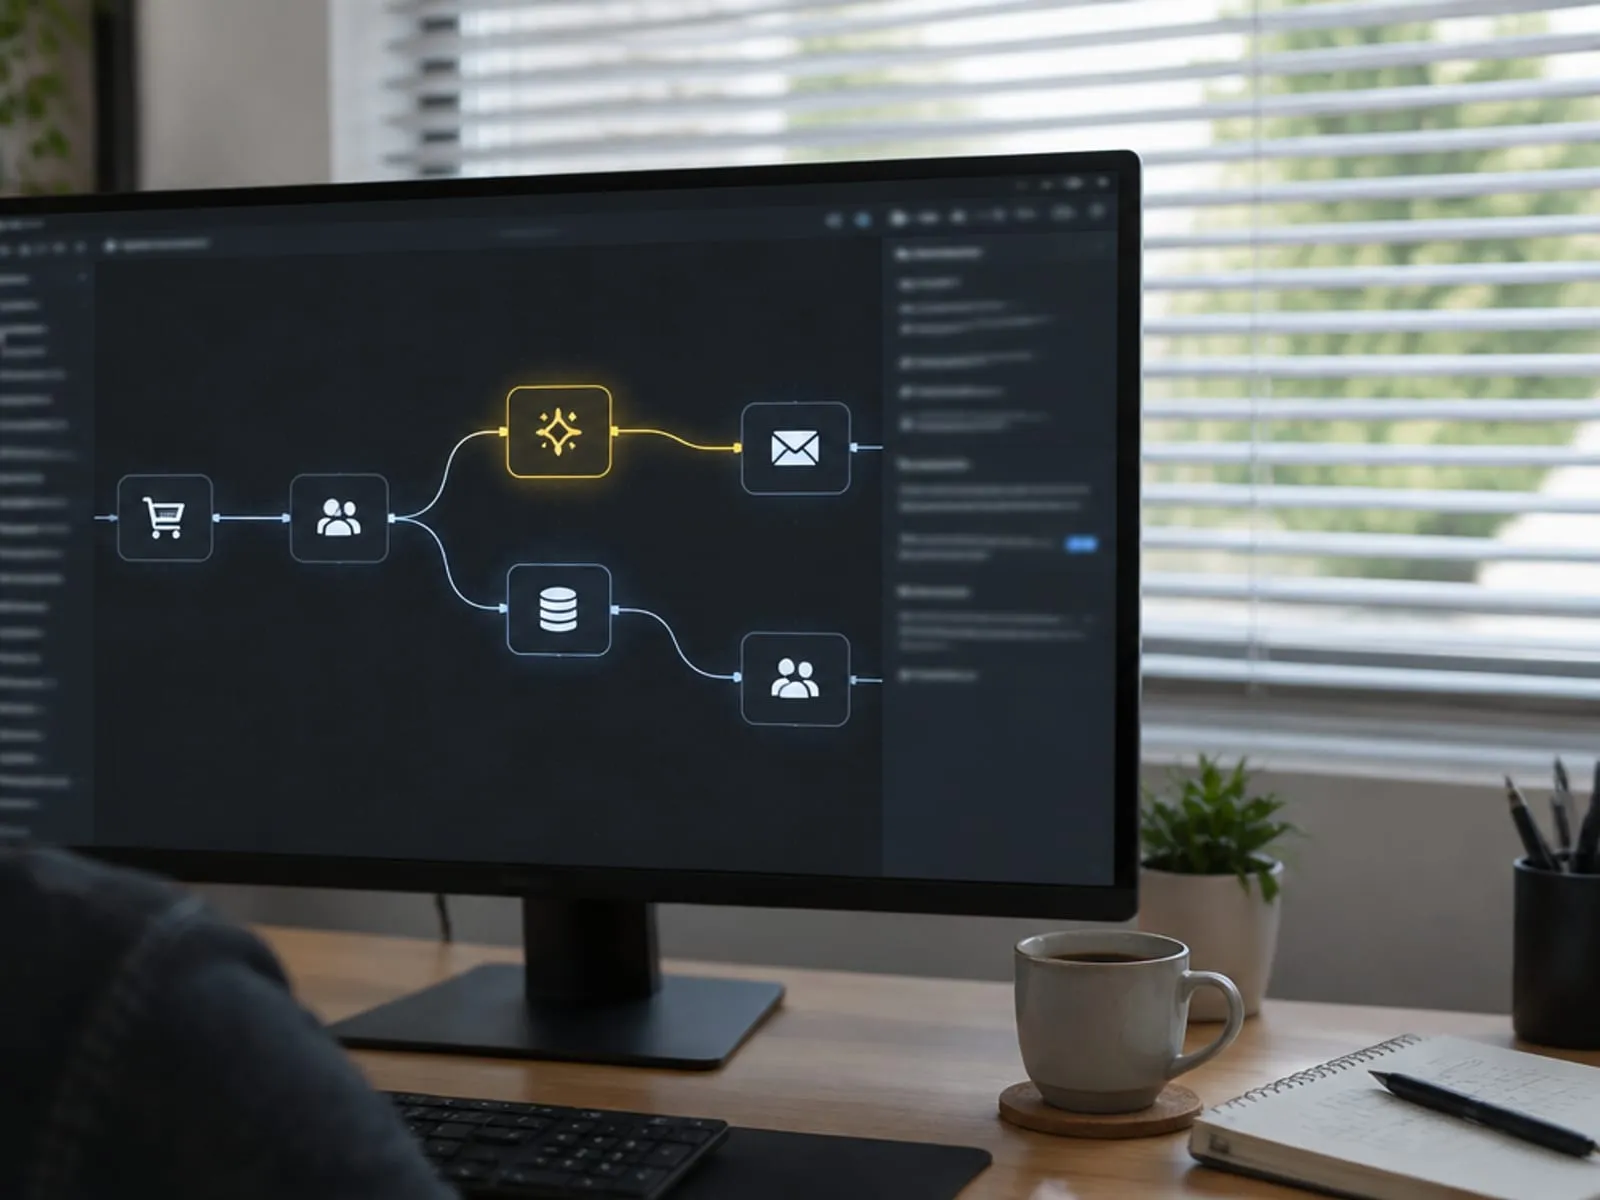
- 5. Nous agissons, avec une validation. Depuis le même chat partent les workflows n8n : ouvrir un ticket, mettre à jour le CRM, préparer un brouillon. Les actions importantes sont validées par une personne.
Comment nous y arrivons
TROIS LEVIERS, DANS CET ORDRE
 01FormationDes formations par métier sur les vrais cas de l’entreprise : ce qu’on peut demander à l’IA, ce qu’on ne peut pas, comment vérifier une réponse. Registres et attestations servent aussi à documenter les mesures exigées par l’article 4 de l’AI Act.Le projet Article 4
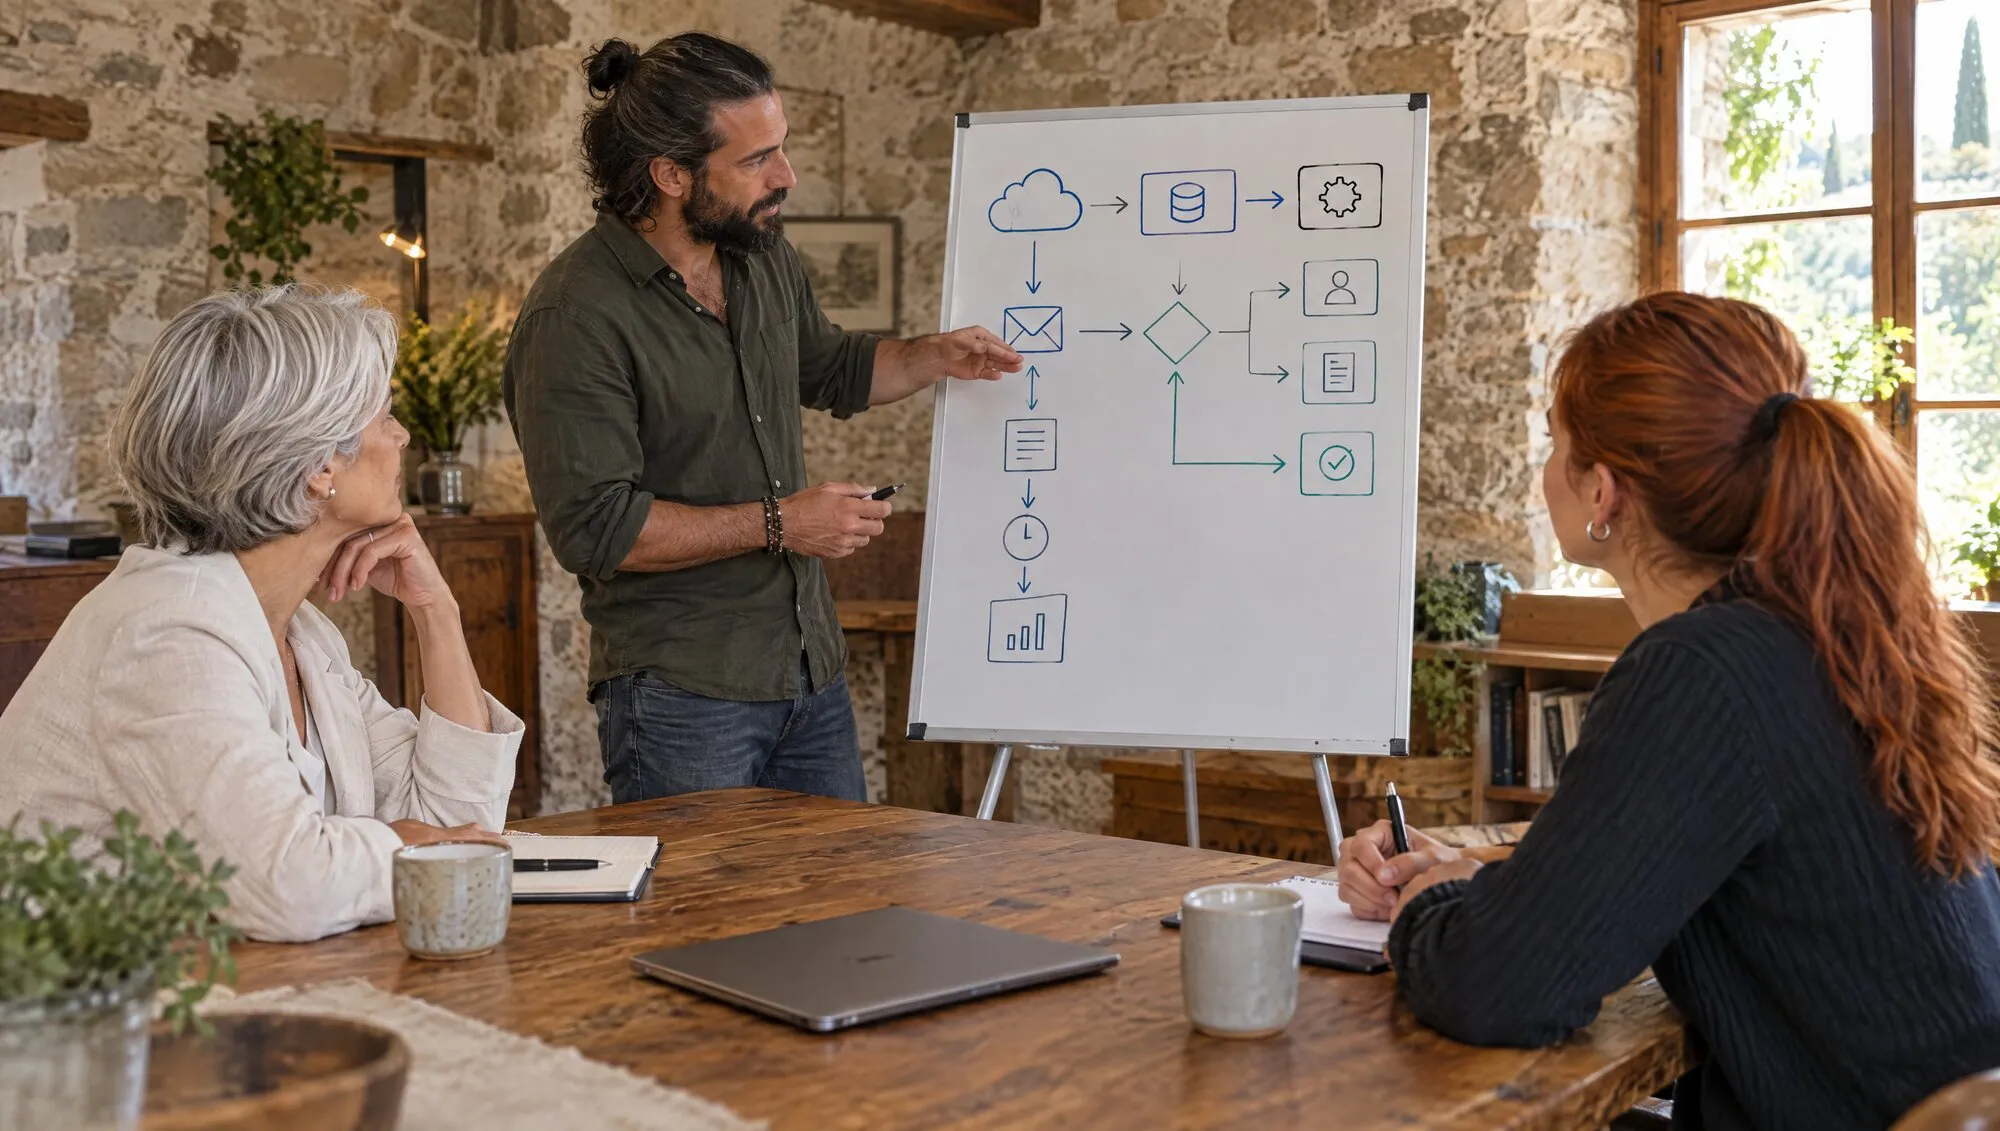 02AutomatisationsDes flux n8n qui font les tâches répétitives à la place des personnes : trier les e-mails, extraire les données des factures et des bons de livraison, mettre à jour le CRM, préparer le rapport du lundi. C’est le premier résultat visible, souvent en quelques semaines.Automatisation et n8n
 03Hub IAL’archive centrale qui répond avec les sources et, via les mêmes workflows, lance les actions. Pour l’équipe, c’est un chat dans les outils qu’elle utilise déjà. Pour les clients, la même connaissance peut alimenter Conversly sur le site.Conversly, pour les clients
Service par service
AVANT ET APRÈS
Aujourd’hui
Pour une offre, on cherche tarifs, fiches techniques et offres similaires entre e-mails et dossiers. Quand on ne trouve pas, on demande au collègue « qui sait ».
Avec le second cerveau
« Prépare une offre pour 200 pièces du modèle X pour le client Y » : le hub récupère l’historique dans le CRM, le tarif en vigueur et les conditions déjà accordées, rédige le brouillon avec les sources et l’enregistre dans le CRM quand vous le validez.
Aujourd’hui
Chaque demande se lit à la main et la réponse change d’un opérateur à l’autre. L’état de la commande, on le demande à l’entrepôt.
Avec le second cerveau
Les e-mails arrivent déjà classés, avec un brouillon de réponse tiré des manuels, des FAQ et de l’état de la commande dans l’ERP. L’opérateur corrige et envoie. Les nouveaux cas enrichissent la base de connaissances.
Aujourd’hui
Manuels, non-conformités et procédures sont dans des PDF éparpillés. Le vrai savoir est dans la tête des seniors, interrompus sans arrêt.
Avec le second cerveau
L’opérateur demande « couple de serrage pour le groupe Z, révision 2024 » et reçoit la valeur avec le lien vers la page du manuel. Un laboratoire industriel français d’environ 200 personnes a mis en production un assistant de ce type en moins d’un mois.
Aujourd’hui
Les nouveaux demandent tout aux collègues et aux RH, et les mêmes questions sur les congés, la sécurité et les procédures reviennent chaque mois.
Avec le second cerveau
Un assistant répond en citant le règlement ou la procédure. Les RH voient quelles questions reviennent et mettent à jour les supports. En Italie, si l’IA entre dans la gestion du personnel, la loi 132/2025 impose d’informer les salariés : nous en tenons compte dès le départ.
Aujourd’hui
Briefs, ton de la marque, fiches produits et résultats des campagnes vivent à des endroits différents. Chaque texte repart de zéro.
Avec le second cerveau
Les brouillons partent des fiches produits officielles et du ton défini une fois pour toutes. Les rapports réunissent les chiffres des campagnes et les notes des commerciaux, et les études de cas déjà écrites se retrouvent.
Aujourd’hui
Factures et bons de livraison se contrôlent à la main. « Où en est le paiement de X ? » passe par trois personnes.
Avec le second cerveau
Les données sont extraites des documents et les rapprochements arrivent déjà proposés, à valider. L’état des paiements se demande au hub, qui le lit dans l’ERP. L’extraction de documents est déjà l’usage de l’IA le plus répandu en Italie.
Le parcours
COMMENT NOUS TRAVAILLONS
Délais indicatifs : ils dépendent du nombre de sources à connecter et de leur état.
Prêt à l’emploi ou sur mesure ?
LE BON OUTIL
Prêt à l’emploi
Si presque tout est dans Microsoft 365 ou Google Workspace et qu’il vous suffit de chercher et d’écrire, Copilot ou Gemini démarrent en quelques jours. Nous vous aidons à les configurer et à former l’équipe.
Sur mesure
Si l’ERP, le CRM et les tickets comptent ensemble, s’il faut des actions et pas seulement des réponses, si vous voulez choisir le modèle et l’hébergement. Nous le construisons avec n8n, une base vectorielle et le modèle le plus adapté.
Hybride, souvent le plus sensé
La suite pour le travail de tous les jours, plus un hub n8n pour les processus et les systèmes que la suite ne voit pas.
Les outils avec lesquels nous travaillons : n8n, Make, OpenAI, Anthropic Claude, Google Gemini, Mistral, modèles open source, Supabase et pgvector, Qdrant, Microsoft 365 Copilot.
Pour éviter les malentendus
CE QUE CE N’EST PAS, ET OÙ L’ON SE TROMPE
Ce que ce n’est pas
- Nous n’entraînons pas de modèle sur vos donnéesLe modèle reste ce qu’il est. Il lit les documents au moment de la question : si un tarif change ou disparaît, la réponse change aussitôt.
- Il ne remplace ni l’ERP ni le CRMIl les interroge et, si besoin, les met à jour. Les données officielles restent là où elles sont aujourd’hui.
- Ce n’est pas ChatGPT avec votre logoIl ne travaille que sur vos sources, respecte les droits de chacun et garde la trace de qui a demandé quoi.
- Il n’est pas infaillibleIl se trompe moins parce qu’il cite la source et peut répondre « je ne sais pas ». Là où une erreur coûte cher, une personne valide.
Les erreurs qui font échouer les projets
Selon Gartner, d’ici 2026, 60 % des projets d’IA sans données prêtes seront abandonnés. Ce n’est presque jamais la faute du modèle.
- 01Des données salesTrois versions du même tarif donnent trois réponses différentes. Avant le pilote, on décide quelle est la source officielle pour chaque sujet.
- 02Aucun responsableSans personne pour tenir les sources à jour, au bout de six mois le hub répond avec des documents dépassés.
- 03Des droits pensés après coupSi le commercial peut lire les fiches de paie, c’est une fuite de données. Les droits sont hérités des systèmes d’origine et testés avec différents utilisateurs.
- 04L’IA « clandestine »Si l’outil de l’entreprise est peu pratique, les gens utilisent des comptes personnels et les données sortent. L’alternative interne doit être plus pratique.
- 05Un projet trop grosToute l’entreprise d’un coup, ça ne démarre jamais. Un service et un processus à la fois, avec un chiffre à améliorer décidé à l’avance.
Le premier pas est petit
Choisissons ensemble un processus et voyons combien de temps il libère
La question qui revient toujours
Et nos données ?
Elles restent les vôtres. Voici comment, point par point.
- Uniquement des comptes professionnelsAvec les API et les offres entreprise d’OpenAI, Anthropic et Microsoft, les contenus n’entraînent pas les modèles. Avec les comptes personnels, souvent si.
- Hébergement en Europe ou chez vousRésidence des données dans l’UE chez les fournisseurs, modèles européens comme Mistral, ou modèles open source et n8n sur vos serveurs.
- AI Act, article 4Depuis le 2 février 2025, ceux qui utilisent l’IA doivent prendre des mesures de maîtrise de l’IA pour leur personnel. Les autorités contrôlent depuis le 2 août 2026.
- AI Act, article 50Depuis le 2 août 2026, toute personne qui parle à un chatbot doit savoir qu’il s’agit d’une IA. Cela vaut pour les assistants destinés aux clients.
- Loi italienne 132/2025En vigueur depuis le 10 octobre 2025 : en Italie, si l’IA entre dans la gestion de la relation de travail, les salariés doivent être informés.
- RGPDContrats de sous-traitance avec les fournisseurs, données minimales, droits par rôle et, si nécessaire, l’analyse d’impact.
Les questions qu’on nous pose
QUESTIONS FRÉQUENTES
Qu’est-ce qu’un second cerveau d’entreprise ?
C’est un point d’accès unique où les personnes de l’entreprise posent des questions en langage naturel et reçoivent des réponses tirées des documents et des systèmes de l’entreprise, avec le lien vers la source et dans le respect des droits de chacun. Depuis ce même point, on peut lancer des actions, comme ouvrir un ticket ou préparer un brouillon d’offre, grâce à des automatisations contrôlées.
Nos données servent-elles à entraîner ChatGPT ou d’autres modèles ?
Avec les comptes professionnels et les API d’OpenAI, Anthropic et Microsoft, les contenus ne sont pas utilisés pour entraîner les modèles. Avec les comptes personnels, souvent si. C’est pourquoi nous travaillons uniquement avec des comptes entreprise et des contrats de traitement des données.
Où sont les données ?
Vous pouvez choisir un hébergement dans l’Union européenne (les principaux fournisseurs le proposent) ou vos propres serveurs avec des modèles open source et n8n installé chez vous, quand les données sont particulièrement sensibles.
Combien de temps pour voir un résultat ?
Une automatisation simple demande quelques semaines. Un pilote du hub sur un service, un ou deux mois. Le reste dépend du nombre de sources à connecter et de leur état.
Faut-il changer d’ERP ou de CRM ?
Non. Le hub se connecte à ce que vous avez déjà, par API ou par des exports réguliers.
Et si l’IA se trompe ?
Cela peut arriver. Chaque réponse cite sa source, on la vérifie donc en un clic. Les actions importantes demandent une validation et la qualité des réponses se mesure dans le temps sur un jeu de questions test.
Tout le monde verra-t-il tout ?
Non. Chacun ne voit que ce qu’il verrait déjà dans les systèmes d’origine. Les droits se conçoivent dès le premier jour.
Sommes-nous obligés de former à l’IA ?
L’article 4 de l’AI Act, en vigueur depuis le 2 février 2025, demande à ceux qui utilisent des systèmes d’IA de prendre des mesures pour la maîtrise de l’IA de leur personnel ; les autorités nationales contrôlent depuis le 2 août 2026. Avec le Digital Omnibus de 2026, aucun niveau ni certificat précis n’est exigé, mais il vaut mieux documenter ce que l’on fait.
Sources des chiffres et des références réglementaires
- ISTAT, Entreprises et TIC, année 2025 (en italien)
- Eurostat, usage de l’IA dans les entreprises de l’UE (2025)
- Observatoire de l’innovation digitale dans les PME, Politecnico di Milano (2026, en italien)
- Commission européenne, maîtrise de l’IA : questions et réponses
- Future of Privacy Forum, calendrier de l’AI Act après le Digital Omnibus (2026)
- Loi italienne sur l’intelligence artificielle (L. 132/2025, en italien)
- EASI-RAG, assistant RAG dans une PME industrielle (arXiv, 2025)